Home / Kennisbank / GEO
Duplicate content, thin content en filter-URL’s: zo los je ze op volgens Google
Duplicate content in één zin: dezelfde of bijna dezelfde inhoud op meer dan één URL. Google straft je daar niet voor: dubbele content op je eigen site is volgens de SEO-starterhandleiding van Google geen schending van het spambeleid en levert geen handmatige actie op. Wel kiest Google dan zelf welke versie het toont, gaat er crawltijd naar URL’s die je niet nodig hebt en raken je cijfers versnipperd.
Ik heb jaren in de ICT gewerkt, onder meer op de servicedesk en in incident- en problemmanagement volgens ITIL. Daar leer je het verschil tussen een incident en een probleem. Een incident is de melding: iets werkt niet. Een probleem is de oorzaak erachter. Los je alleen incidenten op, dan staat dezelfde melding volgende week weer in je lijst.
Incident
503-fouten en een server die aaneengesloten op 100 procent CPU draait
Wat de eigenaar van een ruilkaartenwebshop ziet
Probleem
Filter-URL’s die zes grote crawlers vrij mogen ophalen
Wat de meldingen veroorzaakt
Search Console werkt precies zo. Het rapport Pagina-indexering toont soms tienduizenden meldingen over dubbele pagina’s, filter-URL’s en pagina’s die niet in de index komen. Dat zijn incidenten. Bij de drie webshops in dit artikel komen ze uit een handvol oorzaken: een regel in robots.txt, een filterplugin, een hostwissel en een productstructuur. Hieronder lees je wat Google zelf over duplicate content schrijft, hoe je de oorzaak vindt in plaats van de melding, en hoe dat er bij die webshops en bij mijn eigen site uitziet.
50%
van de crawlproblemen die Google in 2025 zag, kwam door filters
Gary Illyes, Google
25.000
URL’s die Google kende bij een vlaggenwebshop
tegenover 1.340 bereikbare pagina’s
100 → 42%
CPU-belasting voor en na een nieuwe robots.txt
ruilkaartenwebshop, laatste gemeten uur
In het kort
- Duplicate content op je eigen site is geen straf, wel verspilling. Google kiest één canonieke URL en laat de rest buiten beeld.
- Een 301-redirect en rel=”canonical” zijn sterke signalen, een sitemap is een zwak signaal. Robots.txt, de verwijdertool en noindex zijn geen manier om een canonieke versie aan te wijzen.
- Filter-URL’s houd je volgens Google het best buiten de crawl, met robots.txt of URL-fragmenten. Canonical en nofollow werken op lange termijn minder goed.
- Voor AI-overzichten (AI Overviews) en de AI-modus geldt dezelfde basis: een pagina moet geïndexeerd zijn en met een fragment getoond mogen worden.
- Achter duizenden meldingen in Search Console zitten vaak maar een paar oorzaken. Zoek die eerst.
In dit artikel:
- Duplicate content, thin content en filter-URL’s: de verschillen
- Wat Google zelf zegt over duplicate content
- Wat duplicate content doet met je site, je SEO en je GEO
- Duplicate content checken: Search Console en andere tools
- Duplicate content oplossen in 7 stappen
- Filter-URL’s in je webshop: de aanpak van Google
- Thin content: verbeteren, samenvoegen of verwijderen
- Duplicate content voorkomen: checklist
- Veelgestelde vragen
Duplicate content, thin content en filter-URL’s: de verschillen
Duplicate content is dezelfde of bijna dezelfde inhoud op meerdere URL’s. Thin content is een pagina met weinig eigen waarde voor de bezoeker, ook als de tekst uniek is. Filter-URL’s zijn de URL’s die een webshop aanmaakt voor elke combinatie van filters, sortering en acties zoals bestellen. Een filterpagina is vaak een duplicaat van de categoriepagina én dun tegelijk, maar elk probleem vraagt om een eigen aanpak.
Bij duplicate content onderscheid je intern en extern. Interne duplicate content staat op je eigen domein, zoals dezelfde pagina met en zonder www. Externe duplicate content staat op meerdere domeinen, zoals een leverancierstekst die tientallen webshops overnemen.
| Duplicate content | Thin content | Filter-URL’s | |
|---|---|---|---|
| Wat het is | Dezelfde of bijna dezelfde inhoud op meerdere URL’s | Pagina’s met weinig eigen waarde voor de bezoeker | URL’s die ontstaan door filteren, sorteren of acties in een webshop |
| Hoe het ontstaat | www en zonder www, http en https, parameters, kopieën van productteksten | Lege categorieën en tagpagina’s, overgenomen leveranciersteksten, plaatspagina’s waarin alleen de plaatsnaam verschilt | Elke combinatie van kleur, maat, prijs en sortering krijgt een eigen URL |
| Wat Google doet | Kiest één canonieke URL en toont de rest niet | Neemt de pagina niet altijd op in de index | Crawlt veel varianten en ontdekt nieuwe pagina’s trager |
| Oplossing | 301-redirect of rel=”canonical” naar de voorkeursversie | Verbeteren, samenvoegen of verwijderen | Buiten de crawl houden, of gericht laten indexeren |
Wat Google zelf zegt over duplicate content
Google behandelt dubbele content op je eigen site als een technisch probleem, niet als spam. Google kiest zelf één canonieke URL en toont die. Het wordt pas spam als je content van anderen kopieert of op grote schaal pagina’s maakt om rankings of AI-antwoorden te sturen.
Google kiest zelf een canonieke URL
Een canonieke URL (canonical URL) is de versie van een pagina die Google als hoofdversie kiest en in de zoekresultaten toont. Met een canonical tag geef je zelf aan welke versie dat moet zijn. Google bepaalt op basis van de gelijkenis van de inhoud welke pagina’s duplicaten zijn, en kiest zonder jouw voorkeur zelf de URL die het als beste versie voor gebruikers ziet (Google: dubbele URL’s consolideren). Volgens Google doet je site het zonder canonieke voorkeur waarschijnlijk prima.
Wil je zelf sturen, dan heb je drie middelen. Een redirect en een canonical tag zijn volgens Google sterke signalen, een vermelding in je sitemap is een zwak signaal. Sterk is niet hetzelfde als bindend. Search Console heeft er een aparte status voor: “Dubbele pagina, Google heeft een andere canonieke pagina gekozen dan de gebruiker”. Je hebt dan een canonical opgegeven en Google kiest toch een andere URL, meestal omdat je signalen elkaar tegenspreken.
Zo ziet een canonical tag eruit, met een absolute URL zoals Google adviseert:
<link rel="canonical" href="https://www.voorbeeld.nl/gordijnen/linnen-gordijn/" />Wanneer duplicate content wel spam wordt
Andermans content kopiëren is volgens Google “een ander verhaal” dan dubbele content op je eigen site. Het spambeleid van Google noemt vier vormen die hier direct aan raken. Bij scraping neem je content van andere sites over, vaak geautomatiseerd, om rankings te manipuleren. Bij misbruik van geschaalde content maak je veel pagina’s met als hoofddoel rankings te manipuleren, bijvoorbeeld met generatieve AI zonder iets toe te voegen voor de lezer. Doorway-misbruik zijn pagina’s die op vergelijkbare zoekopdrachten moeten ranken; Google noemt als voorbeeld pagina’s per regio of stad die bezoekers naar één pagina sturen. En bij dunne affiliatie komen de productteksten op een pagina met affiliatelinks rechtstreeks van de verkoper.
Google rekent ook pogingen om de generatieve AI-antwoorden in Google Search te manipuleren tot spam. Wie voor elke vraagvariant een aparte pagina maakt om in AI-antwoorden te komen, zit dus in dezelfde categorie.
Plaatspagina’s zijn soms een erfenis van eerder SEO-werk. Bij de kapsalon met webwinkel uit dit artikel stond nog een oude plaatspagina naast een herschreven hoofdpagina voor dezelfde dienst in dezelfde plaats. De oude pagina krijgt een 301 naar de nieuwe, zodat er één pagina overblijft die het onderwerp echt behandelt.
Dunne pagina’s tellen mee voor je hele domein
In het onderdeel over misbruik van sitereputatie schrijft Google dat het er doorgaans van uitgaat dat losse pagina’s, ook nieuwe, dezelfde kwaliteit hebben als de andere pagina’s op het domein. Die aanname staat bij een specifieke vorm van spam, maar ik lees hem breder: honderden lege tag- en filterpagina’s bepalen mee welk beeld Google van je domein heeft.
Wat Google onder waardevolle content verstaat, staat in de vragenlijst voor nuttige content. Biedt de pagina eigen informatie, onderzoek of analyse? Voegt hij duidelijk iets toe ten opzichte van de andere pagina’s in de zoekresultaten? En kopieert of herschrijft hij niet simpelweg andere bronnen? Een vereist aantal woorden bestaat niet. Google schrijft letterlijk dat het geen voorkeur heeft voor een bepaald aantal woorden.
Wat duplicate content doet met je site, je SEO en je GEO
Duplicate content kost crawltijd, kan de verkeerde URL in Google zetten en versnippert je cijfers. Voor AI-antwoorden in Google telt alleen de canonieke versie, omdat die functies op de index van Google draaien. Bij kleine sites is de impact meestal beperkt, bij webshops met filters groot.
Je server en het crawlen
Crawlbudget (crawl budget) is volgens Google het aantal URL’s dat Googlebot op je site kan en wil crawlen. Het is vooral een onderwerp voor grote sites: ruwweg meer dan een miljoen pagina’s die wekelijks veranderen, meer dan 10.000 pagina’s die dagelijks veranderen, of sites met veel URL’s in de status “Gevonden – momenteel niet geïndexeerd” (Google: crawlbudget beheren). Google noemt het aantal URL’s dat het op je site ziet de factor die je zelf het meest kunt beïnvloeden. Noindex helpt daar niet bij: Google vraagt de pagina op en laat hem daarna vallen. Zachte 404’s, pagina’s die “niet gevonden” tonen maar een gewone statuscode geven, blijven ook gecrawld worden.
Case · Ruilkaartenwebshop · Server en crawl
Van 503-fouten naar één fout in robots.txt
Wat filter-URL’s met een server doen, zie ik bij een ruilkaartenwebshop op WooCommerce. De eigenaar krijgt op een zaterdagavond 503-fouten. De hostingpartij ziet geen storing, maar de meters in het hostingpaneel staan aaneengesloten op 100 procent CPU. Dat is het incident.
Het probleem zit in de filter-URL’s. Een audit-crawl telt 52.039 URL’s op een shop met ongeveer 1.000 producten. De 25 traagste pagina’s zijn bijna allemaal URL’s van de filterplugin, met laadtijden van 32 tot 37 seconden. Elke filtercombinatie dwingt een nieuwe databasequery af en is door de parameters in de URL niet te cachen.
Daarbovenop zit er een fout in robots.txt. Onderaan het bestand staan aparte groepen voor Googlebot, Bingbot, GPTBot, ClaudeBot, PerplexityBot en AhrefsBot, elk met Allow: /. Google schrijft in zijn robots.txt-specificatie dat een crawler alleen de groep volgt die het meest specifiek bij zijn naam past, en dat die groep niet wordt gecombineerd met de regels onder User-agent: *. Juist die crawlers mogen daardoor elke filter-URL ophalen.
Na het herschrijven van robots.txt zakken de CPU-belasting en het geheugengebruik direct. De crawlstatistieken in Search Console laten zien wat de overbelasting met Google deed: op de dag van de zware audit-crawl haalt Googlebot nog maar een derde van het aantal pagina’s van de dag ervoor op. De audittool duwde Googlebot van de server af. Negen dagen later komt er een botnet langs met 480.192 verzoeken in 24 uur op dezelfde filter-URL’s. Een bot die robots.txt negeert, houd je alleen op serverniveau tegen, in dit geval via .htaccess.
Ruilkaartenwebshop · server en Googlebot
CPU-belasting
Geheugengebruik
Googlebot-verzoeken op de dag van de zware audit-crawl
De reactietijd voor Googlebot verdubbelt die dag naar 1.181 milliseconden. Bron: hostingpaneel en Google Search Console, juli 2026.
Dit is geen uitzondering. In een podcast over 2025 noemden Gary Illyes en Martin Splitt van Google de verdeling van de crawlproblemen die Google het vaakst tegenkwam (Search Engine Roundtable, 03-02-2026):
Crawlproblemen volgens Google, 2025
Driekwart van de crawlproblemen komt uit filters en actieparameters. Precies de URL’s die een webshop vanzelf aanmaakt.
Je SEO
Duplicate content raakt je SEO op drie manieren: Google toont de verkeerde URL, signalen verdelen zich over varianten, en je cijfers raken versnipperd.
Case · Vlaggenwebshop · Concurrerende varianten
254 maten die allemaal de hoofdversie willen zijn
Bij een vlaggenwebshop heeft elke maat van een vlag een eigen productpagina. In de categorieën landen-, provincie- en gemeentevlaggen gaat het om 254 maatvarianten. Elke variant is indexeerbaar, heeft een canonical naar zichzelf en staat in de sitemap. Technisch klopt alles, en toch concurreren de pagina’s met elkaar: bij 94 procent van de zoekopdrachten in Search Console krijgt meer dan één URL vertoningen. Een duidelijke canonieke URL helpt Google om signalen zoals links op één URL samen te voegen. Hier zijn er 254 die allemaal zeggen dat zij de hoofdversie zijn. Mijn advies: één product per vlag met een keuze voor de maat, met 1.011 redirects.
Vlaggenwebshop · maatvarianten die met elkaar concurreren
Advies: aantal product-URL’s
Bron: Google Search Console en Ahrefs, november 2026.
Case · Kapsalon met webwinkel · Hostwissel
Eén site, twee hostnamen in de cijfers
Bij een kapsalon met webwinkel zie je hoe cijfers versnipperen. Na een verhuizing naar een nieuwe hostingpartij in augustus draait de site op de variant zonder www, met een 301 vanaf www. Die keuze komt uit de verhuisinstructie, waarin het domein zonder www stond. Google verwerkt zo’n wissel niet in één keer: tussen begin augustus en begin november krijgen URL’s met én zonder www vertoningen, de homepage ook. Ook de audittool raakt van slag: het project staat nog op www, de crawler volgt de eerste redirect buiten zijn bereik en stopt na twaalf URL’s zonder één HTML-pagina. Ik maak daarom een domeinproperty aan in Search Console, die www en zonder www samen meet, en zet het auditproject om naar de nieuwe hostnaam.
Kapsalon met webwinkel · één site, twee hostnamen
URL’s met vertoningen
Vertoningen van de homepage
Bron: Google Search Console, begin augustus tot begin november 2026.
Ook parameters versnipperen je cijfers. Bij de vlaggenwebshop staat de homepage met de UTM-tags van de link in het Google Bedrijfsprofiel als losse URL in Search Console, goed voor 11.432 vertoningen in drie maanden. Een pagina met een sorteerparameter kreeg er 117 (bron: Google Search Console, gemeten op 05-11-2026).
Je GEO: zichtbaarheid in AI-antwoorden
Google schrijft in zijn gids voor generatieve AI-functies in Google Search dat AI-overzichten (AI Overviews) en de AI-modus (AI Mode) geworteld zijn in dezelfde ranking- en kwaliteitssystemen als de gewone zoekresultaten. Ze gebruiken twee technieken: retrieval-augmented generation (RAG), waarbij het model informatie uit de index ophaalt, en query fan-out, waarbij het model zelf een reeks verwante zoekopdrachten uitvoert om meer bronnen te vinden.
Een pagina moet geïndexeerd zijn en met een fragment in Google getoond mogen worden om in die antwoorden te kunnen staan. Een duplicaat dat Google niet als canoniek kiest, staat zelf niet in de index. Google gebruikt dan de canonieke versie, en dat is niet altijd de URL die jij wilt. In dezelfde gids noemt Google “minder duplicate content” als technisch aandachtspunt, omdat duplicaten een slechte gebruikerservaring kunnen geven.
Meer pagina’s helpt niet. Een aparte pagina voor elke variant van een zoekvraag, met als doel rankings of AI-antwoorden te sturen, valt volgens Google onder misbruik van geschaalde content, en een groot aantal pagina’s maakt een site volgens Google niet beter of relevanter. Trucs zijn ook niet nodig. Er bestaat volgens Google geen ideale paginalengte, en je hebt geen speciale machineleesbare bestanden, AI-tekstbestanden of extra schema nodig om in de generatieve AI-functies te verschijnen. Google Search gebruikt llms.txt-bestanden zelf niet, schrijft Google erbij.
Voor ChatGPT en Perplexity publiceren de makers geen vergelijkbare richtlijnen over duplicaten. Mijn uitgangspunt is daarom simpel: één duidelijke URL per onderwerp, dan hoeft geen enkel systeem te raden welke pagina het moet citeren. Meer over de basis lees je in wat is GEO.
Duplicate content checken: Search Console en andere tools
In Search Console herken je duplicate content aan de statussen in het rapport Pagina-indexering, vooral de statussen die beginnen met “Dubbele pagina” en “Alternatieve pagina”. De URL-inspectie laat per URL zien welke canonieke versie Google kiest, en Crawlstatistieken laten zien hoeveel crawltijd naar varianten gaat. Voor een tweede controle en voor kopieën op andere sites gebruik je aanvullende tools.
Het rapport Pagina-indexering
Je vindt het onder Indexeren, Pagina’s, in de tabel “Waarom pagina’s niet worden geïndexeerd”. Let op de kolom Bron. Staat daar Website, dan ligt de oorzaak bij je site en kun je hem zelf oplossen. Staat er Google-systemen, dan is het een keuze van Google die je alleen indirect beïnvloedt (Search Console Help: rapport Pagina-indexering).
Twee nuances uit de helppagina van Google over dit rapport. Heeft je site minder dan 500 pagina’s, dan heb je dit rapport volgens Google waarschijnlijk niet nodig. En verwacht niet dat elke URL wordt geïndexeerd: zorg dat de belangrijkste pagina’s in de index staan.
| Status in Search Console | Wat het betekent | Wat je doet |
|---|---|---|
| Alternatieve pagina met correcte canonieke tag | Deze URL verwijst naar een andere canonieke URL en Google volgt dat | Niets, tenzij het er duizenden zijn. Dan crawlt Google veel varianten: haal de bron uit de crawl |
| Dubbele pagina zonder door de gebruiker geselecteerde canonieke versie | Google ziet duplicaten, jij gaf geen voorkeur, Google koos zelf | Kijk welke URL Google koos en geef zelf een canonical of 301 |
| Dubbele pagina, Google heeft een andere canonieke pagina gekozen dan de gebruiker | Google negeert jouw canonical | Zoek de tegenstrijdige signalen: redirects, interne links, sitemap |
| Gecrawld – momenteel niet geïndexeerd | Google heeft de pagina gelezen maar niet opgenomen | Beoordeel de pagina: verbeteren, samenvoegen of verwijderen |
| Gevonden – momenteel niet geïndexeerd | Google kent de URL maar heeft hem nog niet gecrawld | Bij grote aantallen: minder overbodige URL’s aanbieden |
| Zachte 404 | De pagina meldt “niet gevonden” maar geeft geen 404-status | Een echte 404 of 410 geven, of de pagina vullen |
| Uitgesloten door tag noindex | Je hebt de pagina zelf uitgesloten | Controleer of er geen belangrijke pagina’s tussen staan |
| Geblokkeerd door robots.txt | Google mag de URL niet crawlen | Bewust bij filters, controleer of er geen product- of categoriepagina’s tussen staan |
Drie rapporten, drie oorzaken
De drie rapporten hieronder komen uit Search Console, geanonimiseerd en gemaakt op 05-11-2026. Bij elk rapport staat welke oorzaak achter de meldingen zit.
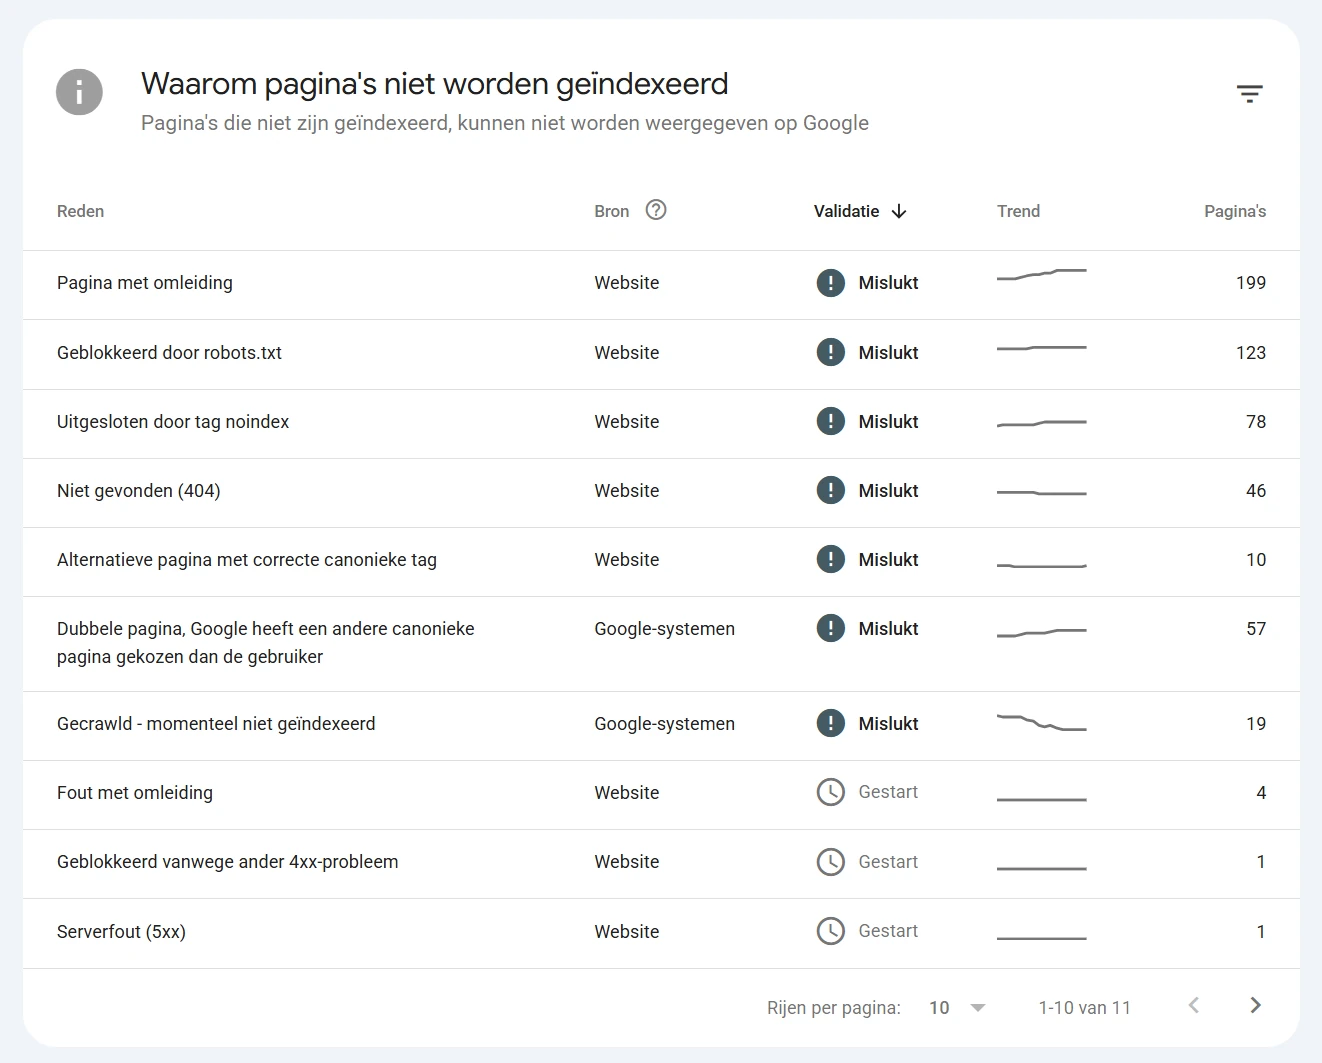
Bij de kapsalon met webwinkel staan 57 pagina’s in de status “Dubbele pagina, Google heeft een andere canonieke pagina gekozen dan de gebruiker”, met Google-systemen als bron. Dat past bij de hostwissel van augustus. De 301 en de canonicals wijzen al naar de variant zonder www, maar Google heeft die keuze nog niet voor elke URL overgenomen. Extra sleutelen aan de canonicals is hier niet nodig. Wat wel helpt, is alles naar dezelfde hostnaam en hetzelfde protocol laten wijzen. Ik heb daarom 273 verwijzingen in de database van http naar https omgezet. In dezelfde ronde kwamen zeven dubbele schema-snippets boven, waarvan twee verouderde versies op de persoonspagina’s een tweede Person-blok maakten. Ook dat is duplicate content, alleen dan in de code.
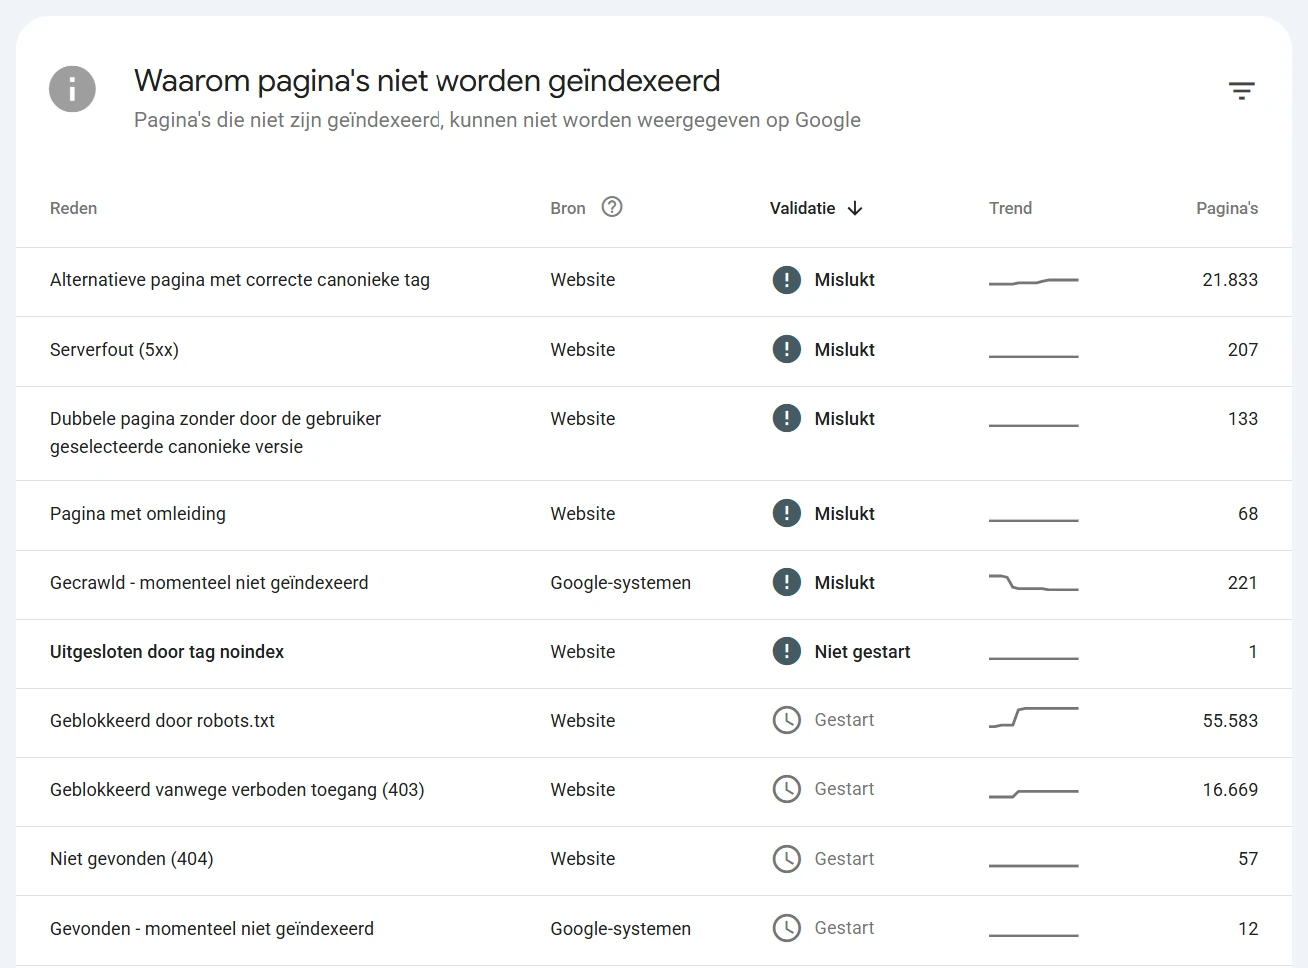
De vlaggenwebshop laat zien hoe ver incidenten en problemen uit elkaar kunnen liggen. Eind augustus kent Google ruim 25.000 URL’s van de site, terwijl een crawler via de links er maar 1.340 vindt.
Vlaggenwebshop · wat Google kent tegenover wat bereikbaar is
URL’s die Google kent: ruim 25.000
Pagina’s die een crawler via de links op de site vindt
Het verschil van bijna 24.000 zijn varianten die geen zelfstandige pagina zijn. Bron: Google Search Console en Ahrefs, eind augustus 2026.
Al die meldingen leiden terug naar drie oorzaken: botfiltering die Googlebot anders behandelt dan een browser, één regel in robots.txt die de paginering blokkeert, en twee webshops die technisch nog één installatie zijn. De regel in robots.txt is Disallow: /*?. Die blokkeert elke URL met een vraagteken, ook de link naar pagina 2 van een categorie (?p=2). Google ziet daardoor van elke categorie alleen pagina 1. In een crawl van eind augustus hebben 326 pagina’s geen bereikbare interne link meer, en 92 daarvan krijgen toch organisch verkeer. Ook de canonicals op de filter-URL’s, die correct naar de categorie wijzen, zijn onleesbaar zolang de regel er staat. In dezelfde periode stijgt het aantal URL’s met “Geblokkeerd door robots.txt” van 8.352 naar ruim 50.000. Inmiddels is de regel weg en loopt de validatie.
De canonicals op de 21.833 alternatieve pagina’s werken, maar Google moet al die varianten wel ophalen om ze te lezen. De serverfouten in dit rapport passen bij de eerste oorzaak, de botfiltering. Bereikbaarheid valt verder buiten dit artikel.
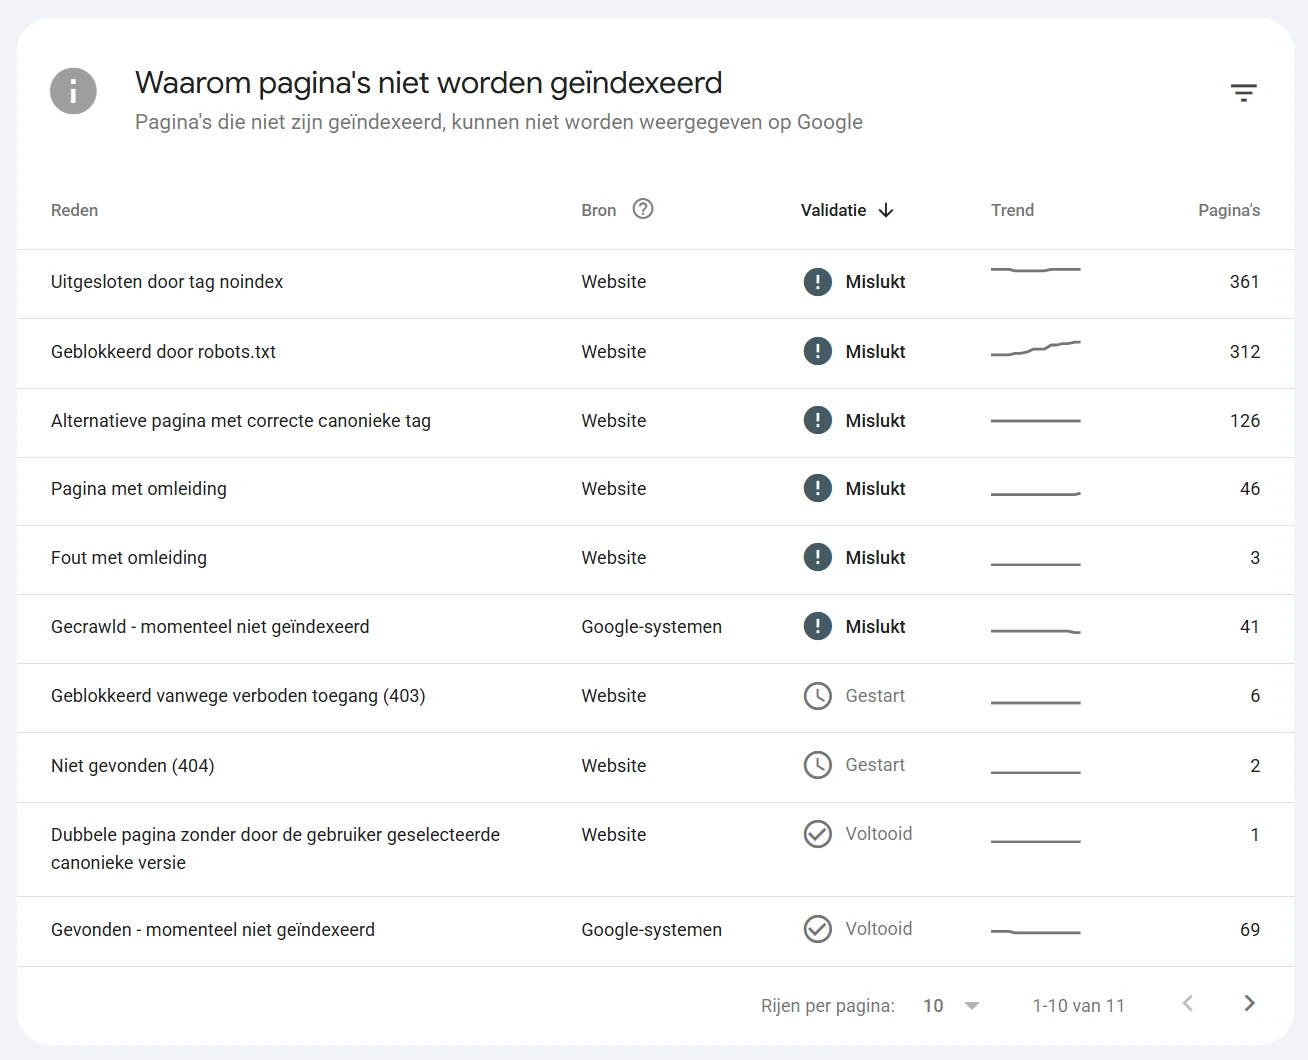
Bij de ruilkaartenwebshop staan noindex (361) en robots.txt (312) bovenaan. Na de herschreven robots.txt staan de filter-URL’s van de filterplugin, met parameters als ?wlfilter=1&woolentor_product_cat=..., bewust buiten de crawl. In de prestatiegegevens duiken daarnaast gepagineerde pagina’s op met een los vraagteken erachter, zoals /page/2/?. Bij de melding over een dubbele pagina zonder canonieke versie staat de validatie op Voltooid.
URL-inspectie
Plak een URL uit een van de statussen in de URL-inspectie. Onder Pagina-indexering zie je twee velden: “Door gebruiker aangegeven canonieke URL” en “Door Google geselecteerde canonieke URL”. Zijn ze verschillend, dan vertrouwt Google een ander signaal meer dan jouw canonical. Gebruik hiervoor de geïndexeerde versie, niet de live test. Google kiest de canonieke URL pas bij het indexeren, en de live test kan volgens Google niet voorspellen of een pagina als canoniek wordt gezien (Search Console Help: URL-inspectie).
Crawlstatistieken
Onder Instellingen vind je Crawlstatistieken. Daar zie je hoeveel verzoeken Googlebot doet, uitgesplitst naar onder meer statuscode en bestandstype, met voorbeeld-URL’s. Staan daar vooral URL’s met filter-, sorteer- of winkelwagenparameters, dan weet je waar je crawltijd naartoe gaat. Bij de ruilkaartenwebshop zag ik hier de terugval van Googlebot op de dag van de zware audit-crawl.
Het rapport Generatieve AI
Google introduceerde in juni 2026 een apart prestatierapport voor generatieve AI in Search Console. Het toont vertoningen in AI-overzichten en de AI-modus. Google wijst de meeste gegevens in dit rapport toe aan de canonieke URL van een pagina en niet aan een dubbele URL (Search Console Help: prestatierapport voor generatieve AI). Kiest Google de verkeerde canonieke URL, dan staan je AI-vertoningen dus ook op de verkeerde pagina. Zie je het rapport nog niet: Google rolt het gefaseerd uit.
Andere tools om duplicate content te checken
- Een site:-zoekopdracht in Google. Voor sites met minder dan 500 pagina’s noemt Google dit zelf als alternatief voor het indexeringsrapport. Zoek op site:jouwdomein.nl en kijk of er varianten tussen staan, zoals URL’s met en zonder www of met parameters.
- Siteliner. Scant je eigen site op interne duplicate content en laat per pagina zien hoeveel tekst overlapt met andere pagina’s.
- Een crawler zoals Ahrefs Site Audit of Screaming Frog. Vindt pagina’s met (bijna) dezelfde inhoud en ontbrekende of tegenstrijdige canonicals.
- Een zin tussen aanhalingstekens. Zoek een unieke zin uit je tekst tussen aanhalingstekens in Google. Zo vind je externe duplicate content: sites die jouw tekst hebben overgenomen, of een leverancierstekst die ook elders staat. Copyscape doet hetzelfde op grotere schaal.
Let op
Stel een crawler wel rustig in. Bij de ruilkaartenwebshop is de audit na de overbelasting teruggezet van 30 naar 3 URL’s per minuut, met URL-parameters uitgesloten en een maximum van 5.000 in plaats van 50.000 pagina’s.
Duplicate content oplossen in 7 stappen
Duplicate content los je op in zeven stappen:
- Exporteer de statussen uit Pagina-indexering.
- Zoek per status het patroon achter de meldingen.
- Kies per duplicaat de maatregel: 301-redirect, canonical of 404/410.
- Haal filter- en actieparameters uit de crawl.
- Verbeter, voeg samen of verwijder dunne pagina’s.
- Zet interne links en sitemap recht.
- Valideer in Search Console en meet het effect.
Stap 1 van 7 · Inventariseren
Stap 1. Exporteer de statussen
Open Pagina-indexering en exporteer per status de voorbeeld-URL’s. Begin bij de statussen met Website als bron. Die kun je zelf oplossen.
Stap 2 van 7 · Van incident naar probleem
Stap 2. Zoek het patroon achter de meldingen
Dit is de stap van incident naar probleem. Haal een handvol URL’s per status door de URL-inspectie, vergelijk jouw canonical met die van Google en zoek wat de URL’s gemeen hebben. De bekende boosdoeners: www tegenover zonder www, http tegenover https, een slash aan het eind of niet, parameters, en in WordPress slugs met -2 erachter. WordPress maakt die aan als een slug al bestaat, vaak een teken van een dubbel product of een vergeten concept. Vind je het patroon, dan los je met één aanpassing honderden meldingen op.
Stap 3 van 7 · Maatregel
Stap 3. Kies per duplicaat de juiste maatregel
- De variant hoeft niet te bestaan (http, de verkeerde hostnaam, een oude URL): 301-redirect naar de voorkeursversie.
- De variant moet blijven bestaan voor bezoekers (sortering, tracking, een productvariant): rel=”canonical” naar de hoofdpagina. In Rank Math en Yoast vul je die per pagina in bij de geavanceerde instellingen.
- De pagina is weg en heeft geen opvolger: een 404 of 410. Google noemt een 404 een sterk signaal om de URL niet opnieuw te crawlen.
- De sitemap: alleen canonieke, indexeerbare URL’s. Een zwak signaal, maar het moet wel kloppen met de rest. Hoe je dat inricht, lees je in wat een goede sitemap oplevert.
Stap 4 van 7 · Crawl
Stap 4. Haal filter- en actieparameters uit de crawl
Filters, sortering en winkelwagenlinks horen niet in de crawl, tenzij een filtercombinatie echte zoekvraag heeft. Hoe je dat doet, lees je bij Filter-URL’s in je webshop.
Stap 5 van 7 · Content
Stap 5. Verbeter, voeg samen of verwijder dunne pagina’s
Pagina’s in “Gecrawld – momenteel niet geïndexeerd” beoordeel je één voor één. De beslisregels lees je bij Thin content: verbeteren, samenvoegen of verwijderen.
Stap 6 van 7 · Links
Stap 6. Zet interne links en sitemap recht
Google adviseert om binnen je site altijd naar de canonieke URL te linken. Controleer menu’s, broodkruimels, knoppen en productlinks. Bij de kapsalon met webwinkel hadden 42 van de 54 404-meldingen dezelfde oorzaak: relatieve links in de footer, zonder slash aan het begin. Een link naar de privacypagina plakte zich daardoor aan elk pad waar een bezoeker op dat moment was, zoals /product-categorie/.../page/4/Privacy. Eén aanpassing in de footer, naar volledige URL’s, nam de oorzaak van die 42 meldingen weg.
Let ook op plugins die automatisch interne links leggen: die blijven soms naar een oude URL verwijzen nadat je alles handmatig hebt aangepast.
Stap 7 van 7 · Meten
Stap 7. Valideer en meet
Klik bij een opgeloste status op “Oplossing valideren”. Validatie duurt volgens Google meestal ongeveer twee weken, maar kan veel langer duren. Meet daarna drie dingen: dalen de aantallen in de statussen, staat de juiste URL in het prestatierapport, en krijgt die URL de vertoningen die eerst over varianten verdeeld waren.
Dit werkt niet om een canonieke versie aan te wijzen
- Robots.txt. Google schrijft letterlijk: gebruik robots.txt niet voor canonicalisatie.
- De verwijdertool in Search Console.
- Noindex. Daarmee haal je de pagina volledig uit Google, in plaats van hem aan een hoofdpagina te koppelen.
- Een relatieve URL in je canonical. Gebruik een volledige URL.
- Interne links naar de dubbele versie terwijl je canonical naar de hoofdversie wijst. Dan spreken je eigen signalen elkaar tegen.
Filter-URL’s in je webshop: de aanpak van Google
Filter-URL’s houd je volgens Google het best buiten de crawl, met robots.txt of door filters in een URL-fragment te zetten. Alleen filtercombinaties met echte zoekvraag laat je indexeren, en dan het liefst als eigen categoriepagina.
In WooCommerce maken de standaard filterwidgets URL’s als ?filter_kleur=rood&query_type_kleur=or, de prijsfilter voegt ?min_price= en ?max_price= toe, sorteren voegt ?orderby= toe en een bestelknop kan ?add-to-cart= aan een URL hangen. Elke combinatie is voor Google een nieuwe URL. Google heeft er een eigen handleiding over gefacetteerde navigatie voor, met twee routes.
Route 1: filter-URL’s niet laten indexeren
Niet indexeren is voor de meeste webshops de juiste route. Google noemt twee manieren. De eerste is blokkeren met robots.txt; Google schrijft dat er vaak geen goede reden is om gefilterde items te laten crawlen. De tweede is filters in een URL-fragment zetten, het deel na de #. Google ondersteunt fragmenten over het algemeen niet bij crawlen en indexeren, dus ze hebben geen invloed op de crawl.
Een voorbeeld voor WooCommerce met de standaard parameters:
User-agent: *
Disallow: /*?*add-to-cart=
Disallow: /*?*filter_
Disallow: /*?*query_type_
Disallow: /*?*min_price=
Disallow: /*?*max_price=
Disallow: /*?*orderby=
Vier aandachtspunten, waarvan drie uit de webshops in dit artikel:
- Eigen parameternamen. Filterplugins gebruiken vaak hun eigen parameters, zoals wlfilter bij de ruilkaartenwebshop. Kijk in Search Console welke parameters jouw webshop echt aanmaakt.
- Groepen per crawler. Zet je aparte groepen voor losse crawlers in robots.txt, dan gelden de regels onder User-agent: * niet meer voor die crawlers. Herhaal je filterregels dus in elke groep, of laat die groepen weg. Bij de ruilkaartenwebshop mochten juist die crawlers hierdoor elke filter-URL ophalen.
- Brede regels.
Disallow: /*?blokkeert alles met een vraagteken, ook paginering als?p=2. Bij de vlaggenwebshop zag Google daardoor alleen pagina 1 van elke categorie. Blokkeer gericht op parameternaam. - Bestaande indexering. Staan er al veel filter-URL’s in de index, laat ze dan eerst uitvallen voordat je ze blokkeert. Een geblokkeerde URL leest Google niet meer, dus ook een noindex of canonical op die pagina ziet Google dan niet. Controleer daarna met het robots.txt-rapport in Search Console dat je categorie- en productpagina’s bereikbaar blijven.
Route 2: filter-URL’s wel laten indexeren
Kies voor indexeren alleen als filtercombinaties echte zoekvraag hebben. Google geeft er vier regels voor:
- Gebruik het standaard scheidingsteken & tussen parameters. Komma’s, puntkomma’s en haakjes herkennen crawlers slecht.
- Houd de volgorde van filters altijd gelijk en voorkom dat hetzelfde filter twee keer in een URL staat.
- Geef een 404 als een filtercombinatie geen resultaten heeft. Dat geldt ook voor dubbele of onzinnige combinaties en voor paginanummers die niet bestaan.
- Stuur zulke lege combinaties niet door naar een algemene foutpagina. Geef de 404 op de URL zelf.
Waarom canonical en nofollow hier tekortschieten
Google noemt rel=”canonical” en rel=”nofollow” voor filters op lange termijn minder effectief dan robots.txt of fragmenten. Een canonical naar de ongefilterde pagina kan het crawlvolume van de varianten na verloop van tijd verlagen, maar Google moet die varianten eerst wel blijven ophalen. Nofollow werkt alleen als elke link naar die URL het attribuut heeft. De vlaggenwebshop laat het zien: 21.833 varianten met een correcte canonical, en toch allemaal gecrawld.
Een filter met zoekvolume wordt een categoriepagina
Zoeken mensen echt op een combinatie, zoals linnen gordijnen in een bepaalde kleur, maak er dan een eigen categorie- of landingspagina van. Met een eigen URL, een korte intro en interne links vanuit de hoofdcategorie. De filter-URL zelf blijft buiten de crawl. Voor de vlaggenwebshop adviseer ik geen enkele filtercombinatie te laten indexeren en 48 producten per pagina te tonen, zodat elke vlag op de eerste pagina van zijn categorie staat. Meer over categoriepagina’s lees je in SEO voor je webshop en in SEO en GEO voor webshops.
Thin content: verbeteren, samenvoegen of verwijderen
Thin content los je op door per pagina te kiezen: verbeteren, samenvoegen met een sterkere pagina of verwijderen. Een minimum aantal woorden bestaat niet; het gaat om eigen informatie en toegevoegde waarde.
Per dunne pagina neem ik drie vragen door, in deze volgorde:
1
Heeft de pagina een functie?
Geen bezoekers, geen links, geen zoekvraag en geen taak voor de klant: verwijderen met een 404 of 410. Heeft hij wel een taak voor bezoekers, zoals een accountpagina, dan mag hij blijven en hoeft hij niet in Google.
2
Bestaat er een sterkere pagina over hetzelfde onderwerp?
Samenvoegen. Neem de beste stukken over en zet een 301 van de zwakke naar de sterke pagina.
3
Is het onderwerp waardevol maar de pagina mager?
Verbeteren met eigen informatie: je eigen ervaring, cijfers, voorbeelden of een vergelijking die nergens anders staat.
Dun is niet hetzelfde als waardeloos. Bij de vlaggenwebshop hebben elf pagina’s minder dan vijftig woorden tekst en krijgen ze toch organisch verkeer. Een provincievlag met vijf woorden tekst trekt 54 bezoekers per maand. Zulke pagina’s verwijder je niet. Daar is de vraag er al, alleen het antwoord ontbreekt nog.
Productteksten van leveranciers zijn de klassieke valkuil. Dezelfde tekst staat bij tientallen webshops, en Google heeft weinig reden om juist jouw versie te tonen. Herschrijf eerst je bestsellers en je categorieën. Alles tegelijk hoeft niet.
Uit mijn eigen werk · Samenvoegen
Twee artikelen over schema-markup, geen van beide in Google
Ik had twee artikelen over schema-markup, één op mijn persoonlijke site en één op studiodeaup.nl. Elk had sterke stukken die het andere miste, en geen van beide rankte op het onderwerp. Ik heb de sterkste onderdelen van allebei samengevoegd in het artikel op studiodeaup.nl: de herkomst van schema.org, een JSON-LD-voorbeeld, de manieren om schema in WordPress toe te voegen en de veelgestelde vragen. Bij het nalopen van de links bleek dat een plugin nog automatisch vier interne links naar het oude adres legde. Ook dat is duplicate content: niet één grote fout, maar losse instellingen die elkaar tegenspreken. Het resultaat lees je in wat is schema-markup en waarom AI het nodig heeft.
Duplicate content voorkomen: checklist voor WordPress en webshops
Duplicate content voorkom of vermijd je met twaalf vaste instellingen en gewoontes. De meeste zet je één keer goed in WordPress of in je webshop, en controleer je opnieuw na een verhuizing of een grote update.
Checklist
- Eén hostnaam en https: alle varianten sturen met een 301 naar één versie. Na een verhuizing controleer je dit opnieuw, ook in je Search Console-property en je audittools.
- Elke pagina heeft een canonical naar zichzelf, met een volledige URL. Rank Math en Yoast doen dat standaard; controleer het na een thema- of pluginwissel.
- Menu’s, broodkruimels en interne links wijzen naar de canonieke URL, met volledige URL’s in plaats van relatieve links.
- De sitemap bevat alleen canonieke, indexeerbare URL’s.
- Filter-, sorteer- en winkelwagenparameters staan buiten de crawl.
- Robots.txt blokkeert gericht op parameternaam, zonder brede regels als
Disallow: /*?en zonder losse crawlergroepen die je filterregels omzeilen. - UTM-tags gebruik je alleen in links van buitenaf, zoals je Bedrijfsprofiel of nieuwsbrief, nooit in interne links.
- Slugs met -2 erachter onderzoek je direct: meestal een dubbel product of een vergeten concept.
- Structured data staat één keer per pagina. Dubbele snippets geven dubbele schema-blokken.
- Bestsellers en categorieën hebben een eigen tekst, geen leverancierstekst.
- Plaatspagina’s maak je alleen als je per plaats echt iets eigens te vertellen hebt.
- Staging- en testomgevingen staan achter een wachtwoord.
Wil je de technische basis van WordPress verder op orde brengen, lees dan technische SEO voor WordPress. Twijfel je tussen SEO-plugins, dan zet ik ze naast elkaar in Rank Math vs Yoast. Begrippen als canonical en crawlbudget staan in de GEO-begrippenlijst. Wil je het laten oplossen, dan doe ik dat binnen onpage en technische SEO.
Gratis Deaup AI-Scan
Weten waar jouw website nu staat? De scan laat zien of Google en AI je pagina’s kunnen lezen en waar de eerste winst zit.
Veelgestelde vragen over duplicate content
Wat is duplicate content?
Duplicate content is dezelfde of bijna dezelfde inhoud op meer dan één URL, op je eigen site of op andere sites. Google kiest dan één versie als canonieke URL en toont de andere versies niet.
Krijg je een straf van Google voor duplicate content?
Nee. Een duplicate content penalty bestaat niet voor dubbele content op je eigen site. Volgens Google is het geen schending van het spambeleid en leidt het niet tot een handmatige actie. Google kiest wel zelf welke versie het toont. Content van andere sites kopiëren is iets anders en kan wel onder het spambeleid vallen.
Wat is het verschil tussen interne en externe duplicate content?
Interne duplicate content staat op je eigen domein, zoals dezelfde pagina met en zonder www of met een filterparameter. Externe duplicate content staat op meerdere domeinen, zoals een leverancierstekst die tientallen webshops gebruiken. Interne duplicaten los je op met redirects en canonicals, externe met een eigen tekst.
Hoe check je je website op duplicate content?
Begin met het rapport Pagina-indexering in Search Console en kijk naar de statussen die beginnen met “Dubbele pagina” en “Alternatieve pagina”. Siteliner en crawlers zoals Ahrefs Site Audit of Screaming Frog vinden interne duplicaten. Externe kopieën vind je door een unieke zin uit je tekst tussen aanhalingstekens in Google te zoeken.
Wat is een canonical tag?
Een canonical tag is een regel in de code van een pagina die aangeeft welke URL de hoofdversie is, bijvoorbeeld <link rel="canonical" href="https://www.voorbeeld.nl/pagina/" />. Google ziet het als een sterk signaal, maar kiest toch een andere URL als je andere signalen iets anders zeggen.
Moet ik filterpagina’s op noindex zetten?
Google adviseert voor filters robots.txt of URL-fragmenten, omdat noindex geen crawltijd bespaart. Google vraagt een noindex-pagina op en laat hem daarna vallen. Staan er al filter-URL’s in de index, laat ze dan eerst via noindex uitvallen en blokkeer ze daarna.
Heeft duplicate content invloed op AI-overzichten (AI Overviews)?
Ja, indirect. AI-overzichten en de AI-modus gebruiken de index en de rankingsystemen van Google. Alleen geïndexeerde pagina’s die met een fragment getoond mogen worden, komen in aanmerking. Google noemt minder duplicate content zelf als aandachtspunt in zijn gids voor generatieve AI-functies.
Wat is crawl budget?
Crawl budget is het aantal URL’s dat Googlebot op je site kan en wil crawlen. Voor de meeste sites is het geen probleem. Google noemt het vooral relevant voor sites met ruwweg meer dan een miljoen pagina’s, sites met meer dan 10.000 pagina’s die dagelijks veranderen, en sites met veel URL’s in “Gevonden – momenteel niet geïndexeerd”. Webshops met veel filters lopen er wel eerder tegenaan.
Bronnen
- Google Search Central: dubbele URL’s consolideren
- Google Search Central: SEO-starterhandleiding
- Google Search Central: spambeleid
- Google Search Central: nuttige, betrouwbare content maken
- Google Search Central: gids voor generatieve AI-functies in Google Search
- Google Search Central: robots.txt-specificatie
- Google Crawling: gefacetteerde navigatie
- Google Crawling: crawlbudget beheren
- Search Console Help: rapport Pagina-indexering
- Search Console Help: URL-inspectie
- Search Console Help: prestatierapport voor generatieve AI
- Search Engine Roundtable: Google’s top crawling challenges for 2025
Bron cijfers: Google Search Console, Ahrefs en de werkverslagen van drie webshops, mei tot en met november 2026. De webshops zijn geanonimiseerd.